第9章 群(Group)与半群(Semigroup)
9.1 再论二元运算(binary operation )
我们知道,集合A上的二元运算是一个处处有定义的函数f : A × A → A f:A×A\rarr A f : A × A → A
满足以下性质
二元运算必须为A的每个有序元素对而定义(对每个有序对都适用,满射 )
每个有序对仅对应A中唯一的元素(单射 )
采用 * 号来表示二元运算
再添加以下性质
运算* 下A是封闭的(closed ) ,a , b ∈ A 那么 a ∗ b ∈ A a,b\in A 那么 a*b\in A a , b ∈ A 那么 a ∗ b ∈ A
若对于a , b ∈ A , a ∗ b = b ∗ a a,b\in A,a*b=b*a a , b ∈ A , a ∗ b = b ∗ a 交换的(commutative ) ,如果构造一张运算表,那么可以看到值是关于主对角线对称的
若对于a , b , c ∈ A , a ∗ ( b ∗ c ) = ( a ∗ b ) ∗ c a,b,c\in A,a*(b*c)=(a*b)*c a , b , c ∈ A , a ∗ ( b ∗ c ) = ( a ∗ b ) ∗ c 结合的(associative )
若对于a ∈ A , a ∗ a = a a\in A,a*a=a a ∈ A , a ∗ a = a 幂等的(idempotent )
设A = { x 1 , x 2 , . . . , x n } A=\{x_1,x_2,...,x_n\} A = { x 1 , x 2 , ... , x n } A A A 2 n 2 2^{n^2} 2 n 2
9.2 半群(Semigroup )
将一个非空集合S S S S S S 可结合的 二元运算*,构成以下结构
( S , ∗ ) (S,*)
( S , ∗ )
就表示半群
可以把a ∗ b a*b a ∗ b
如果* 是一个交换运算,就称半群( S , ∗ ) (S,*) ( S , ∗ ) 交换半群 。
对A = { a 1 , a 2 , . . . , a n } A=\{a_1,a_2,...,a_n\} A = { a 1 , a 2 , ... , a n } A ∗ A^* A ∗ A A A A ∗ A^* A ∗ ⋅ \cdot ⋅ ( S , ⋅ ) (S,\cdot) ( S , ⋅ ) 自由半群(free semigroup generated by A ) 。
接下来是一些概念
单位元(identity element ) e e e ( S , ∗ ) (S,*) ( S , ∗ ) a ∈ S a\in S a ∈ S
e ∗ a = a ∗ e = a e*a=a*e=a
e ∗ a = a ∗ e = a
称e为单位元,是唯一的
幺半群(monoid ) 有单位元的半群( S , ∗ ) (S,*) ( S , ∗ )
子半群(subsemigroup ) 有一半群(S,* ),若T T T S S S T T T ( T , ∗ ) (T,* ) ( T , ∗ ) ( S , ∗ ) (S,*) ( S , ∗ )
子幺半群(submonoid ) 与子半群类似,有一幺半群(S,* ),若T T T S S S T T T T T T ( T , ∗ ) (T,* ) ( T , ∗ ) ( S , ∗ ) (S,*) ( S , ∗ )
同构(Isomorphism )
( S , ∗ ) (S,*) ( S , ∗ ) ( T , ∗ ′ ) (T,*^{'}) ( T , ∗ ′ ) f : S → T f:S\rarr T f : S → T S S S T T T a , b ∈ S a,b\in S a , b ∈ S f ( a ∗ b ) = f ( a ) ∗ ′ f ( b ) f(a*b)=f(a)*^{'}f(b) f ( a ∗ b ) = f ( a ) ∗ ′ f ( b ) f : S → T f:S\rarr T f : S → T ( S , ∗ ) (S,*) ( S , ∗ ) ( T , ∗ ′ ) (T,*^{'}) ( T , ∗ ′ ) 同构
说人话就是:
两个半群S和T,存在一个函数f,变量为S,结果为T,满足单射,满射,且f(a*b)=f(a) *’ f(b),那么f就是从S到T的一个同构
f − 1 f^{-1} f − 1 S和T是同构的,就记为S=T
证明半群( S , ∗ ) (S,*) ( S , ∗ ) ( T , ∗ ′ ) (T,*^{'}) ( T , ∗ ′ )
先定义一个函数f : S → T , D o m ( f ) = S f:S\rarr T,Dom(f)=S f : S → T , Do m ( f ) = S
证明 f f f
证明 f f f
证明 f ( a ∗ b ) = f ( a ) ∗ ′ f ( b ) f(a*b)=f(a)*'f(b) f ( a ∗ b ) = f ( a ) ∗ ′ f ( b )
来道题就懂了
设T是所有偶数的集合,证明半群(Z,+)与(T,+)是同构的
定义 f : Z → T f:Z\rarr T f : Z → T
先证明单射。假设f(a1)=f(a2),那么就有2a1=2a2,所以a1=a2,因此f就是单射
再证明满射。假设b是任意偶数,那么就有 b / 2 = a ∈ Z b/2=a\in Z b /2 = a ∈ Z f ( a ) = f ( b / 2 ) = 2 ( b / 2 ) = b f(a)=f(b/2)=2(b/2)=b f ( a ) = f ( b /2 ) = 2 ( b /2 ) = b
最后,f(a+b)=2a+2b=f(a)+f(b)
故他们是同构的
同态(homomorphism )
在两个半群同构的条件下,去掉满足单射,满射的条件,即设( S , ∗ ) (S,*) ( S , ∗ ) ( T , ∗ ′ ) (T,*') ( T , ∗ ′ ) f : S → T f:S→T f : S → T S S S f ( a ∗ b ) = f ( a ) ∗ ′ f ( b ) f(a*b)=f(a)*'f(b) f ( a ∗ b ) = f ( a ) ∗ ′ f ( b ) f f f ( S , ∗ ) (S,*) ( S , ∗ ) ( T , ∗ ′ ) (T,*') ( T , ∗ ′ ) 同态 。如果 f f f T T T S S S 同态象(homomorphic image ) 。
同构与同态的差异就是同构必须单射和满射,相同之处就是都必须有积的象等于象的积
定理: 设( S , ∗ ) (S, *) ( S , ∗ ) ( T , ∗ ′ ) (T, *') ( T , ∗ ′ ) e e e e ′ e' e ′ f : S → T f:S→T f : S → T ( S , ∗ ) (S,*) ( S , ∗ ) ( T , ∗ ′ ) (T,*') ( T , ∗ ′ ) f ( e ) = e ′ f(e)=e' f ( e ) = e ′
定理: 设 f f f ( S , ∗ ) (S,*) ( S , ∗ ) ( T , ∗ ′ ) (T,*') ( T , ∗ ′ ) S ′ S' S ′ ( S , ∗ ) (S,*) ( S , ∗ )
f ( S ′ ) = { t ∈ T ∣ t = f ( s ) ,对 s ∈ S ′ } f(S')=\{t\in T|t=f(s),对s\in S'\}
f ( S ′ ) = { t ∈ T ∣ t = f ( s ) ,对 s ∈ S ′ }
即在 f f f S ′ S' S ′ ( T , ∗ ′ ) (T,*') ( T , ∗ ′ )
因此,f ( S ′ ) f(S') f ( S ′ ) ∗ ′ *' ∗ ′ T T T f ( S ′ ) f(S') f ( S ′ ) f ( S ′ ) f(S') f ( S ′ ) ( T , ∗ ′ ) (T,*') ( T , ∗ ′ )
9.3 半群的积与商(PRODUCTS AND QUOTIENTS OF SEMIGROUPS )
看标题就知道,半群进行积与商的运算,将会从已有的半群产生新的半群,这一节就是阐述新半群与老半群的关系
定理: 如果( S , ∗ ) (S,*) ( S , ∗ ) ( T , ∗ ′ ) (T,*') ( T , ∗ ′ ) ( S × T , ∗ ′ ′ ) (S×T,*'') ( S × T , ∗ ′′ ) ∗ ′ ′ *'' ∗ ′′ ( s 1 , t 1 ) ∗ ′ ′ ( s 2 , t 2 ) = ( s 1 ∗ s 2 , t 1 ∗ ′ t 2 ) (s_1,t_1)*''(s_2,t_2)=(s_1*s_2,t_1*'t_2) ( s 1 , t 1 ) ∗ ′′ ( s 2 , t 2 ) = ( s 1 ∗ s 2 , t 1 ∗ ′ t 2 )
也就是说,假设S和T是分别有单位元e1,e2的幺半群,那么S×T是有单位元(e1,e2)的幺半群
同余关系(congruence relation )
如果 a R a ′ aRa' a R a ′ b R b ′ bRb' b R b ′ ( a ∗ b ) R ( a ′ ∗ b ′ ) (a*b)R(a'*b') ( a ∗ b ) R ( a ′ ∗ b ′ ) ( S , ∗ ) (S,*) ( S , ∗ ) 等价关系 R R R 同余关系
要证明R是某一半群( S , ∗ ) (S,*) ( S , ∗ )
先证明R是一个等价关系(自反,对称,传递)
再证明同余关系的a R a ′ aRa' a R a ′ b R b ′ bRb' b R b ′ ( a ∗ b ) R ( a ′ ∗ b ′ ) (a*b)R(a'*b') ( a ∗ b ) R ( a ′ ∗ b ′ )
商半群 quotient semigroup (因子半群)factor semigroup
我们已经知道,半群上的等价关系决定半群的一个划分。
对半群( S , ∗ ) (S,*) ( S , ∗ ) R R R [ a ] = R ( a ) [a]=R(a) [ a ] = R ( a ) S / R S/R S / R
定理: 设R R R ( S , ∗ ) (S,*) ( S , ∗ ) S / R × S / R S/R×S/R S / R × S / R S / R S/R S / R ⊛ \circledast ⊛
⊛ \circledast ⊛ S / R × S / R S/R×S/R S / R × S / R S / R S/R S / R [ a ] ⊛ [ b ] [a]\circledast [b] [ a ] ⊛ [ b ] ⊛ ( [ a ] , [ b ] ) \circledast ([a],[b]) ⊛ ([ a ] , [ b ])
[ a ] ⊛ [ b ] = [ a ∗ b ] [a]\circledast [b]=[a*b]
[ a ] ⊛ [ b ] = [ a ∗ b ]
( S / R , ⊛ ) (S/R,\circledast) ( S / R , ⊛ ) 商半群 或因子半群 。
可以得出以下推论:
R R R ( S , ∗ ) (S,*) ( S , ∗ ) ⊛ \circledast ⊛ [ a ] ⊛ [ b ] = [ a ∗ b ] [a]\circledast [b]=[a*b] [ a ] ⊛ [ b ] = [ a ∗ b ] ( S / R , ⊛ ) (S/R,\circledast) ( S / R , ⊛ )
接下来说明的都是半群与商半群之间的关系
定理: 设R是半群(S,*)上的一个同余关系,( S / R , ⊛ ) (S/R,\circledast) ( S / R , ⊛ ) f R ( a ) = [ a ] 定义的函数 f R : S → S / R f_R(a)=[a]定义的函数f_R:S\rarr S/R f R ( a ) = [ a ] 定义的函数 f R : S → S / R 自然同态
**同态基本定理:**设f : S → T f:S\rarr T f : S → T ( S , ∗ ) (S,*) ( S , ∗ ) ( T , ∗ ′ ) (T,*') ( T , ∗ ′ ) R R R S S S R R R S S S f ( a ) = f ( b ) f(a)=f(b) f ( a ) = f ( b )
R R R ( T , ∗ ′ ) (T,*') ( T , ∗ ′ ) ( S / R , ⊛ ) (S/R,\circledast) ( S / R , ⊛ )
9.4 群
幺半群的集合中所有元素都拥有逆元且逆元在该集合中,则称该幺半群为群 ,表示为( G , ∗ ) (G,*) ( G , ∗ )
逆元(inverse ) 对于每个元素a ∈ G a\in G a ∈ G b ∈ G b\in G b ∈ G a ∗ b = b ∗ a = e a*b=b*a=e a ∗ b = b ∗ a = e a , b a,b a , b
也就是说一个普通的代数系统要成为群需要满足下面几个条件:
例如<C, +>, <R, +>, <Q, +>为群, 而<R, *>不再为群, 因为0没有逆元。
阿贝尔群(Abelian )
对于群G中的所有元素a,b有
a b = b a ab=ba
ab = ba
那么群G就是阿贝尔群
对幺半群Z n Z_n Z n Z n Z_n Z n
群的一些基本性质
群G中的每个元素a在G中有且仅有一个逆元,记为a − 1 a^{-1} a − 1
那么上面那条逆元的定义式可以改成a a − 1 = a − 1 a = e aa^{-1}=a^{-1}a=e a a − 1 = a − 1 a = e
(左/右消去性质)ab=ac 推出 b=c ,ba=ca 推出 b=c
设a ∈ G , M a : G → G a \in G,M_a:G\rarr G a ∈ G , M a : G → G M a ( g ) = a g M_a(g)=ag M a ( g ) = a g M a M_a M a
( a − 1 ) − 1 = a (a^{-1})^{-1}=a ( a − 1 ) − 1 = a
( a b ) − 1 = b − 1 a − 1 (ab)^{-1}=b^{-1}a^{-1} ( ab ) − 1 = b − 1 a − 1
a , b ∈ G a,b\in G a , b ∈ G
对称群(symmetric group )
n个元素的所有置换的集合在合成运算下是一个阶为n!的群,称这个群为n个字母上的对称群 ,用S n S_n S n
子群(subgroup )
设H H H G G G
G中的单位元e e e H H H
a , b ∈ H , a b ∈ H a,b\in H,ab\in H a , b ∈ H , ab ∈ H a ∈ H , a − 1 ∈ H a\in H,a^{-1}\in H a ∈ H , a − 1 ∈ H
则称H为G的一个子群
有单位元,存在封闭性,说明H是G的子幺半群,所以一个子幺半群如果有逆元,那就是一个子群
以下是一些更深的定义
平凡子群(trivial subgroup )
在群G G G G G G H = { e } H=\{e\} H = { e } G G G G G G
交错群(alternating group )
这个的前置条件是偶置换,没学,不说了
定理: 设( G , ∗ ) (G,*) ( G , ∗ ) ( G ′ , ∗ ′ ) (G',*') ( G ′ , ∗ ′ ) f : G → G ′ f:G\rarr G' f : G → G ′ G G G G ′ G' G ′
若e e e G G G e ‘ e‘ e ‘ G ’ G’ G ’ f ( e ) = e ′ f(e)=e' f ( e ) = e ′
若a ∈ G a\in G a ∈ G f ( a − 1 ) = ( f ( a ) ) − 1 f(a^{-1})=(f(a))^{-1} f ( a − 1 ) = ( f ( a ) ) − 1
若H H H G G G f ( H ) = { f ( h ) ∣ h ∈ H } f(H)=\{f(h)|h\in H\} f ( H ) = { f ( h ) ∣ h ∈ H } G ′ G' G ′
9.5 群的积与商(PRODUCTS AND QUOTIENTS OF GROUPS )
定理: 如果G 1 G_1 G 1 G 2 G_2 G 2 G = G 1 × G 2 G=G_1×G_2 G = G 1 × G 2 ( a 1 , b 1 ) ( a 2 , b 2 ) = ( a 1 a 2 , b 1 b 2 ) (a_1,b_1)(a_2,b_2)=(a_1a_2,b_1b_2) ( a 1 , b 1 ) ( a 2 , b 2 ) = ( a 1 a 2 , b 1 b 2 ) G n G_n G n
定理: 设R R R ( G , ∗ ) (G,*) ( G , ∗ ) ( G / R , ⊛ ) (G/R,\circledast) ( G / R , ⊛ ) ⊛ \circledast ⊛ G / R G/R G / R [ a ] ⊛ [ b ] = [ a ∗ b ] [a]\circledast [b]=[a*b] [ a ] ⊛ [ b ] = [ a ∗ b ]
定理: 设R是群(G,*)上的一个同余关系,那么由f R ( a ) = [ a ] 定义的函数 f R : G → G / R f_R(a)=[a]定义的函数f_R:G\rarr G/R f R ( a ) = [ a ] 定义的函数 f R : G → G / R
定理: 设f : G → G ′ f:G\rarr G' f : G → G ′ ( G , ∗ ) (G,*) ( G , ∗ ) ( G ′ , ∗ ′ ) (G',*') ( G ′ , ∗ ′ ) R R R G G G R R R G G G f ( a ) = f ( b ) f(a)=f(b) f ( a ) = f ( b )
R R R 由f ‾ ( [ a ] ) = f ( a ) \overline f([a])=f(a) f ([ a ]) = f ( a ) f ‾ : G / R → G ′ \overline f:G/R\rarr G' f : G / R → G ′ ( G / R , ⊛ ) (G/R,\circledast) ( G / R , ⊛ ) ( G ′ , ∗ ′ ) (G',*') ( G ′ , ∗ ′ )
左培集与右陪集(left/right coset )
群G有一子群H,a ∈ G a\in G a ∈ G
由a a a
a H = { a h ∣ h ∈ H } aH=\{ah|h\in H\}
a H = { ah ∣ h ∈ H }
由a a a
H a = { h a ∣ h ∈ H } Ha=\{ha|h\in H\}
H a = { ha ∣ h ∈ H }
a称为陪集的代表元素
若对G中所有的a有aH=Ha,则称G的子群H是正规子群(normal subgroup )
这其实是说明了对a定义的左陪集aH,其实就是a在G上的一个等价类[a]
阿贝尔群的每个子群都是一个正规子群
R R R a ∈ G a\in G a ∈ G [ a ] = a H = H a [a]=aH=Ha [ a ] = a H = H a
定理: 设N是群G的一个正规子群,R是G上的关系,满足aRb当且仅当a − 1 b ∈ N a^{-1}b\in N a − 1 b ∈ N
R是G上的同余关系
N是关于R的等价类[e],其中e是G的单位元
从以上定理可以看到,如果G是任意一个群,那么G上的同余关系的等价类总是G的某个正规子群的陪集 。反之,G的任意一个正规子群的陪集恰好是关于G上某个同余关系的等价类。所以,现在可以作如下解释:设f f f ( G , ∗ ) (G,*) ( G , ∗ ) ( G ′ , ∗ ′ ) (G',*') ( G ′ , ∗ ′ ) f f f 核 记做k e r ( f ) ker( f ) k er ( f )
k e r ( f ) = { a ∈ G ∣ f ( a ) = e ′ } ker(f)=\{a\in G|f(a)=e'\}
k er ( f ) = { a ∈ G ∣ f ( a ) = e ′ }
那么
ker( f )是G的一个正规子群
商群G/ker( f )与G’是同构的
环
特别地,令S S S + + + ∗ * ∗ ( S , + , ∗ ) (S,+,*) ( S , + , ∗ )
如果* 满足结合律,那么结构( S ,+, ∗ ) (S,+,*) ( S ,+, ∗ ) 环 。
如果* 同时满足结合律和交换律,则称( S ,+, ∗ ) (S,+,*) ( S ,+, ∗ ) 交换环 。
如果( S , ∗ ) (S,*) ( S , ∗ ) ( S ,+, ∗ ) (S,+,*) ( S ,+, ∗ ) 含幺环 。
∗ * ∗
第11章 编码
11.1 编码
11.2 译码与纠错
一个满射函数d : B n → B m d:B^n\rarr B^m d : B n → B m
设e是一个(m, n)编码函数,d是与e相关的一个(n, m)译码函数。如果无论x=e(b)是正确地传输还是有k个或更少的错误传输并且接收的是x t x_t x t d ( x t ) = b d (x_t)=b d ( x t ) = b x t x_t x t
已知一个(m,n)编码函数e : B m → B n e:B^m→B^n e : B m → B n d : B n → B m d:B^n→B^m d : B n → B m 最大似然方法 ,它从一个已知e确定一个译码函数d。
因为B m B^m B m 2 m 2^m 2 m B n B^n B n 2 m 2^m 2 m
x ( 1 ) , x ( 2 ) , . . . , x ( 2 m ) x^{(1)},x^{(2)},...,x^{(2m)}\\
x ( 1 ) , x ( 2 ) , ... , x ( 2 m )
假设我们通过e收到的字是x t x_t x t 2 m 2^m 2 m x t x_t x t i i i i i i 1 ≤ i ≤ 2 m 1\le i \le 2^m 1 ≤ i ≤ 2 m δ ( x ( i ) , x t ) \delta (x^{(i)},x_t) δ ( x ( i ) , x t )
汉明距离δ ( x ( i ) , x t ) = ∣ x ( i ) ⊕ x t ∣ \delta (x^{(i)},x_t)=|x^{(i)}\oplus x_t| δ ( x ( i ) , x t ) = ∣ x ( i ) ⊕ x t ∣
按照汉明距离从小到大排列,选出距离最小且原始排序靠前的那一个代码字,也就是与x t x_t x t x ( s ) x^{(s)} x ( s )
我们由上述操作求到了x ( s ) x^{(s)} x ( s ) x ( s ) = e ( b ) x^{(s)}=e(b) x ( s ) = e ( b )
d ( x t ) = b \\d(x_t)=b\\
d ( x t ) = b
来定义与e有关的最大似然译码函数 d d d
定理: 已知e是一个(m,n)编码函数,d是与e有关的最大似然译码函数,那么(e,d)能纠正 k \ k k 2 k + 1 2k+1 2 k + 1
直接上题目好理解:e的最短距离假设为3,那么有3 ≥ 2 k + 1 , 也就是 k ≤ 1 3\ge 2k+1,也就是k\le 1 3 ≥ 2 k + 1 , 也就是 k ≤ 1
接下来,我们要采用一种方法,来方(fu)便(za)地求出与e有关的最大似然译码函数 d d d
我们需要一条定理: 如果K是群G的一个有限子群,那么G中K的每一个左陪集与K恰好有同样多的元素。
设e : B m → B n e:B^m\rarr B^n e : B m → B n B n B^n B n N N N 2 m 2^m 2 m N = { x ( 1 ) , x ( 2 ) , . . . , x ( 2 m ) } N=\{x^{(1)},x^{(2)},...,x^{(2^m)}\} N = { x ( 1 ) , x ( 2 ) , ... , x ( 2 m ) }
从上面的分析,我们再次假设代码字$ x=e(b)被传输并且收到的字是 被传输并且收到的字是 被传输并且收到的字是 。 。 。
x t ⊕ N = { ϵ 1 , ϵ 2 , . . . , ϵ 2 m } , ϵ i = x t ⊕ x ( i ) x_t\oplus N=\{\epsilon_1,\epsilon_2,...,\epsilon_{2^m}\},\\
\epsilon_i=x_t\oplus x^{(i)}
x t ⊕ N = { ϵ 1 , ϵ 2 , ... , ϵ 2 m } , ϵ i = x t ⊕ x ( i )
从x t x_t x t x ( i ) x^{(i)} x ( i ) ϵ i \epsilon_i ϵ i ∣ ϵ i ∣ |\epsilon_i| ∣ ϵ i ∣
因此,如果存在一个ϵ j \epsilon_j ϵ j x ( j ) x^{(j)} x ( j ) x t x_t x t
此时,x ( j ) = ϵ j ⊕ x t x^{(j)}=\epsilon_j\oplus x_t x ( j ) = ϵ j ⊕ x t
我们称一个有最小权的ϵ j \epsilon_j ϵ j 陪集首部(coset leader ) ,它不是唯一的
接下来,我们开始进行求解过程
如果e : B m → B n e:B^m→B^n e : B m → B n
确定B n B^n B n
对每个陪集求陪集首部,也就是求其中具有最小权的字。
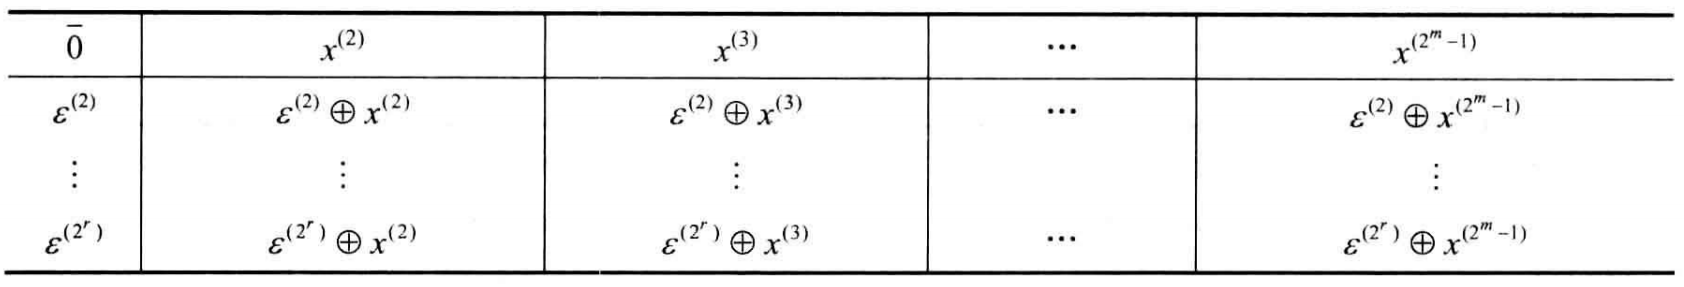
我们可以采用列表法来确定B n B^n B n N N N N = { x ( 1 ) , x ( 2 ) , . . . , x ( 2 m ) } N=\{x^{(1)},x^{(2)},...,x^{(2^m)}\} N = { x ( 1 ) , x ( 2 ) , ... , x ( 2 m ) } x ( 1 ) = 0 ‾ x^{(1)}=\overline 0 x ( 1 ) = 0
第一行:从单位元 0 ‾ \overline0 0 N N N
0 ‾ \overline0 0 x ( 2 ) x^{(2)} x ( 2 ) x ( 2 m ) x^{(2^m)} x ( 2 m )
这其实是陪集[ 0 ‾ \overline 0 0 0 ‾ \overline 0 0 ϵ 1 \epsilon_1 ϵ 1
现在选择未列在第一行里B n B^n B n y y y y ⊕ N y\oplus N y ⊕ N
y ⊕ 0 ‾ y\oplus\overline0 y ⊕ 0 y ⊕ x ( 2 ) y\oplus x^{(2)} y ⊕ x ( 2 ) y ⊕ x ( 2 m ) y\oplus x^{(2^m)} y ⊕ x ( 2 m )
在陪集y ⊕ N y\oplus N y ⊕ N ϵ 2 \epsilon_2 ϵ 2
依次类推,下一行选择没有在前两行的任意字,选出最小权元素作为陪集首部,最后得表
最后,我们将需要进行译码的 x t x_t x t x ( i ) x^{(i)} x ( i ) d ( x ( i ) ) d(x^{(i)}) d ( x ( i ) ) b b b
如果我们知道(m, n)群码是e H : B m → B n e_H:B^m→B^n e H : B m → B n H H H
H = [ h 11 h 12 ⋯ h 1 r h 21 h 22 ⋯ h 2 r ⋮ ⋮ ⋮ h m 1 h m 2 ⋯ h m r 1 0 ⋯ 0 0 1 ⋯ 0 ⋮ ⋮ ⋮ 0 0 ⋯ 1 ] H=\begin{bmatrix}
h_{11}&h_{12}&\cdots&h_{1r}\\
h_{21}&h_{22}&\cdots&h_{2r}\\
\vdots&\vdots&&\vdots\\
h_{m1}&h_{m2}&\cdots&h_{mr}\\
1&0&\cdots&0\\
0&1&\cdots&0\\
\vdots&\vdots&&\vdots\\
0&0&\cdots&1\\
\end{bmatrix}
H = h 11 h 21 ⋮ h m 1 1 0 ⋮ 0 h 12 h 22 ⋮ h m 2 0 1 ⋮ 0 ⋯ ⋯ ⋯ ⋯ ⋯ ⋯ h 1 r h 2 r ⋮ h m r 0 0 ⋮ 1
由f H ( x ) = x ∗ H f_H(x)= x *H f H ( x ) = x ∗ H f H : B n → B r f_H:B^n→B^r f H : B n → B r B n B^n B n B r B^r B r
由定理: 如果m , n , r , H m, n, r, H m , n , r , H f H f_H f H f H f_H f H
可得,
g ( x N ) = f H ( x ) = x ∗ H g(xN)=f_H(x)=x*H
g ( x N ) = f H ( x ) = x ∗ H
元素x ∗ H x*H x ∗ H x x x 校验子(syndrome ) .
定理: 设x和y是B n B^n B n B n B^n B n N N N f H ( x ) = f H ( y ) f_H(x)=f_H(y) f H ( x ) = f H ( y )
于是,我们得出了更简便求最大似然译码函数的方法:
确定B n B^n B n N = e H ( B m ) N=e_H(B^m) N = e H ( B m )
对每个陪集,求陪集首部并且计算所有首部的校验子
如果收到x t x_t x t x t x_t x t ϵ \epsilon ϵ x t ⊕ ϵ = x x_t\oplus \epsilon=x x t ⊕ ϵ = x e H ( b ) e_H(b) e H ( b ) d ( x t ) = b d(x_t)=b d ( x t ) = b
对于上面这个过程,不需要保存一张陪集表,并且能够避免计算译码表的工作量。而只要简单地以任意顺序一次列出所有陪集,并且从每个陪集中选择一个陪集首部。然后保存这些陪集首部和它们的校验子的一张表。上面的步骤很容易用这张表实现。
来道例题说明:
考虑奇偶校验矩阵
H = [ 1 1 0 1 0 1 0 1 1 1 0 0 0 1 0 0 0 1 ] H=\begin{bmatrix}
1&1&0\\
1&0&1\\
0&1&1\\
1&0&0\\
0&1&0\\
0&0&1\\
\end{bmatrix}
H = 1 1 0 1 0 0 1 0 1 0 1 0 0 1 1 0 0 1
和(3,6)群e H : B 3 → B 6 e_H:B^3\rarr B^6 e H : B 3 → B 6
得到代码字
还记得代码字怎么求吗?
我们知道m和n,就能从B m B^m B m
比如m=3,n=6
B m B^m B m
那么我们就构造一个字,个数为6,就是010 x 1 x 2 x 3 010x_1x_2x_3 010 x 1 x 2 x 3
x 1 = b 1 h 11 + b 2 h 21 + b 3 h 31 = 1 x_1=b_1h_{11}+b_2h_{21}+b_3h_{31}=1 x 1 = b 1 h 11 + b 2 h 21 + b 3 h 31 = 1
x 2 = b 1 h 12 + b 2 h 22 + b 3 h 32 = 0 x_2=b_1h_{12}+b_2h_{22}+b_3h_{32}=0 x 2 = b 1 h 12 + b 2 h 22 + b 3 h 32 = 0
x 3 = b 1 h 13 + b 2 h 23 + b 3 h 33 = 1 x_3=b_1h_{13}+b_2h_{23}+b_3h_{33}=1 x 3 = b 1 h 13 + b 2 h 23 + b 3 h 33 = 1
那么代码字就是010101
要注意算x1,x2,x3的时候,和式中只有含有奇数个1,结果才能为1
代码字 { e ( 000 ) = 000000 e ( 001 ) = 001011 e ( 010 ) = 010101 e ( 011 ) = 011110 e ( 100 ) = 100110 e ( 101 ) = 101101 e ( 110 ) = 110011 e ( 111 ) = 111000 \begin{align*}
\begin{split}
代码字 \left \{
\begin{array}{ll}
e(000)=000000\\
e(001)=001011\\
e(010)=010101\\
e(011)=011110\\
e(100)=100110\\
e(101)=101101\\
e(110)=110011\\
e(111)=111000\\
\end{array}
\right.
\end{split}
\end{align*}
代码字 ⎩ ⎨ ⎧ e ( 000 ) = 000000 e ( 001 ) = 001011 e ( 010 ) = 010101 e ( 011 ) = 011110 e ( 100 ) = 100110 e ( 101 ) = 101101 e ( 110 ) = 110011 e ( 111 ) = 111000
因此N = { 000000 , 001011 , 010101 , 011110 , 100110 , 101101 , 110011 , 111000 } N=\{000000,001011,010101,011110,100110,101101,110011,111000\} N = { 000000 , 001011 , 010101 , 011110 , 100110 , 101101 , 110011 , 111000 }
检验子
陪集首部
000
000000
001
000001
010
000010
011
001000
100
000100
101
010000
110
100000
111
001100
计算x t ∗ H x_t*H x t ∗ H ϵ \epsilon ϵ
那么再将x t ⊕ ϵ x_t \oplus \epsilon x t ⊕ ϵ
对应的e(011)=011110,则b=011
在进行x t ∗ H x_t*H x t ∗ H x t x_t x t H H H